Anthropic libera IA mais poderosa para equipes que caçam falhas antes de hackers
A Anthropic ampliou o acesso a modelos avançados como o Claude Opus 5.5 para equipes de cibersegurança verificadas, após o Project Glasswing ajudar a identificar ao menos 129 mil vulnerabilidades entre abril e julho de 2026.
Por Marina Sato · Repórter de IA
O que mudou
A Anthropic, criadora do assistente de IA Claude e concorrente da OpenAI, passou a liberar seus modelos mais avançados — Claude Opus 5.5, Claude Sonnet 5.5 e Claude Mythos 5.1 — para equipes de cibersegurança verificadas, com menos restrições de segurança digital aplicadas a esses usos específicos. O novo programa, batizado de Cyber Verification Program, organiza o acesso em três níveis.
Os três níveis de acesso
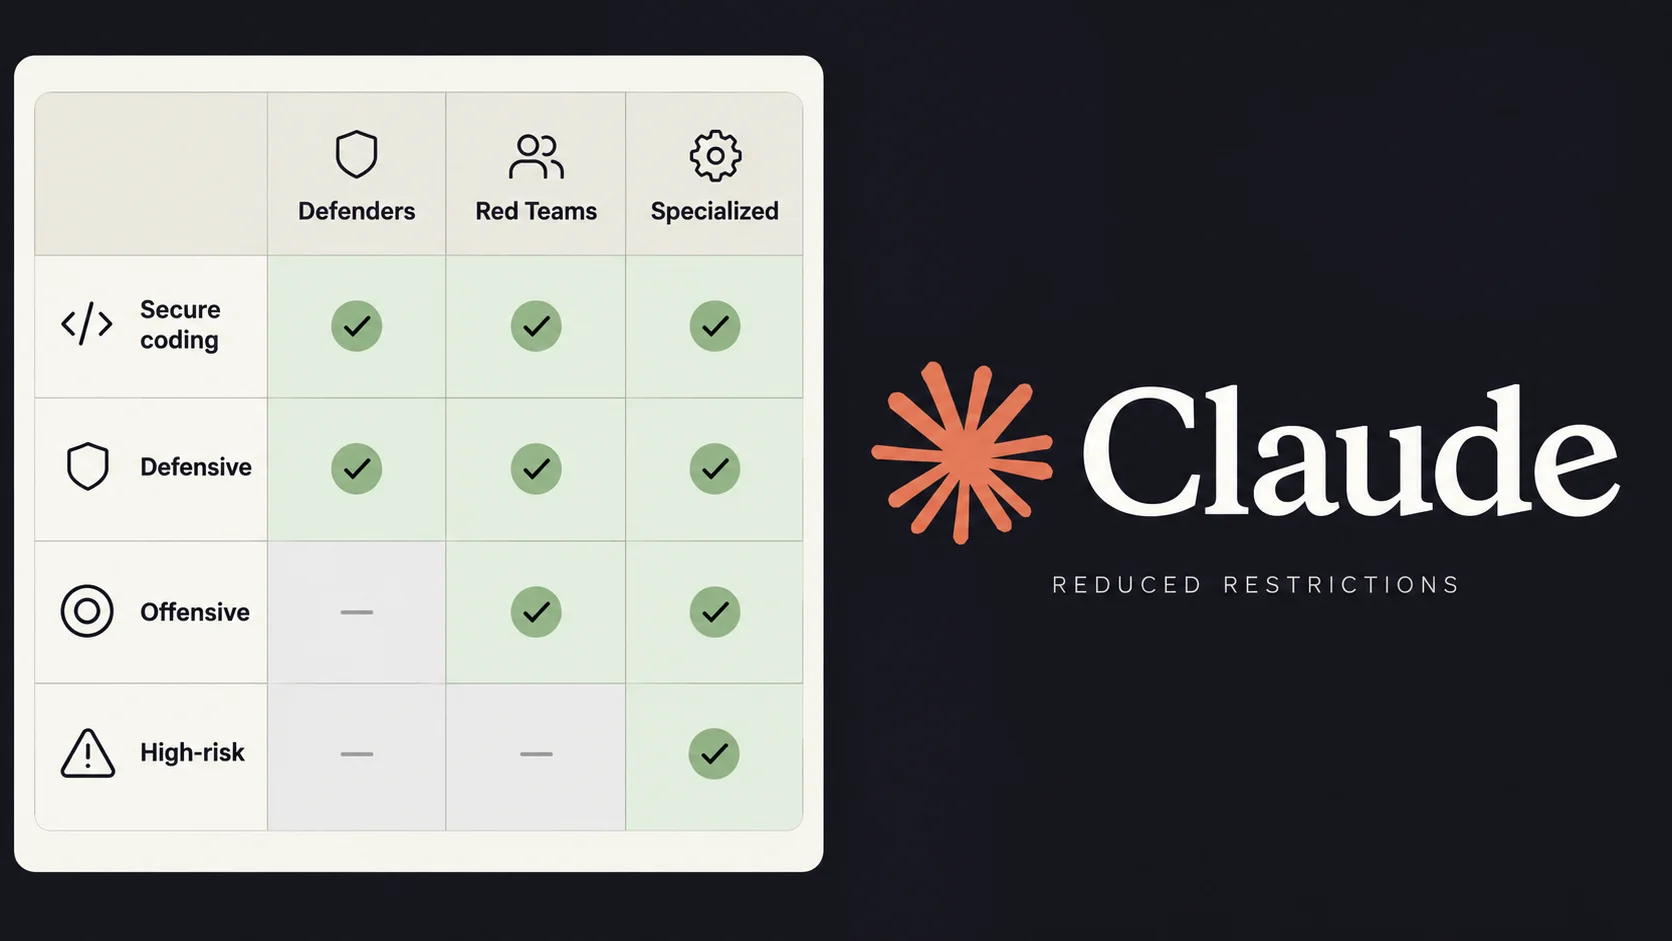 Foto: reprodução/cybersecuritynews.com
No nível Defense estão equipes de segurança corporativa, operadores de infraestrutura crítica, mantenedores de projetos de código aberto e pesquisadores de vulnerabilidades. O nível Red Team é reservado a organizações autorizadas a realizar testes de invasão. Já o Specialized Access, o mais permissivo, atende um grupo restrito que testa sistemas críticos como redes elétricas, aviação e infraestrutura bancária — todos passam por verificação conjunta com o governo dos Estados Unidos.
O legado do Project Glasswing
A iniciativa sucede o Project Glasswing, programa-piloto que usava o Claude Mythos para ajudar parceiros a encontrar falhas de segurança antes que criminosos as explorassem. Entre abril e julho de 2026, os parceiros do Glasswing identificaram ao menos 129 mil vulnerabilidades verificadas. A própria Anthropic, em varredura de projetos de código aberto realizada entre abril e outubro, encontrou outras 5,5 mil falhas — somando 134 mil vulnerabilidades no total, das quais mais de 33 mil foram classificadas como críticas ou de alta gravidade. A empresa estima que o impacto real seja pelo menos cinco vezes maior que o número já verificado.
Os riscos da liberação
Abrir mais capacidade de ataque cibernético para IA é uma faca de dois gumes. Testes internos mostraram que o acesso público bloqueia qualquer tentativa de uso malicioso já no primeiro prompt. Mas no nível Red Team, sem as travas de segurança padrão, os modelos completaram tarefas ofensivas sem bloqueio nenhum — resultado próximo da taxa de sucesso observada quando não há proteção alguma.
O que ainda falta responder
A Anthropic não detalha publicamente quantas organizações já migraram para os novos níveis de acesso, nem como pretende evitar que credenciais verificadas sejam usadas de forma indevida por agentes internos maliciosos. Também não há prazo definido para que os concorrentes lancem modelos com capacidade cibernética equivalente — a própria empresa admite que isso pode acontecer em poucos meses.