Nova teoria tenta explicar como a IA realmente "pensa" por dentro
Pesquisador ligado à Goodfire, startup de interpretabilidade de IA avaliada em US$ 1,25 bilhão, afirma que padrões de ativação dos neurônios artificiais podem ser decifrados. A ideia ainda é teórica, mas pode ajudar a tornar sistemas avançados mais seguros.
Por Elias Brandão · Analista de IA e ética
O problema: uma IA é uma caixa-preta
Imagine abrir o capô de um carro e, em vez de motor, encontrar um emaranhado de fios sem rótulo. É mais ou menos assim que pesquisadores descrevem o interior de uma rede neural: dá para ver o que entra (a pergunta) e o que sai (a resposta), mas o caminho no meio costuma ser um mistério, mesmo para quem construiu o sistema.
Uma nova teoria, publicada em 15 de outubro por Nick Cammarata, pesquisador que ajudou a criar a área de interpretabilidade mecanística na OpenAI e hoje assessora a Goodfire, startup americana de interpretabilidade de IA avaliada em US$ 1,25 bilhão, sugere que essa bagunça interna pode ser mais organizada do que se pensava.
A analogia do neurônio "confuso"
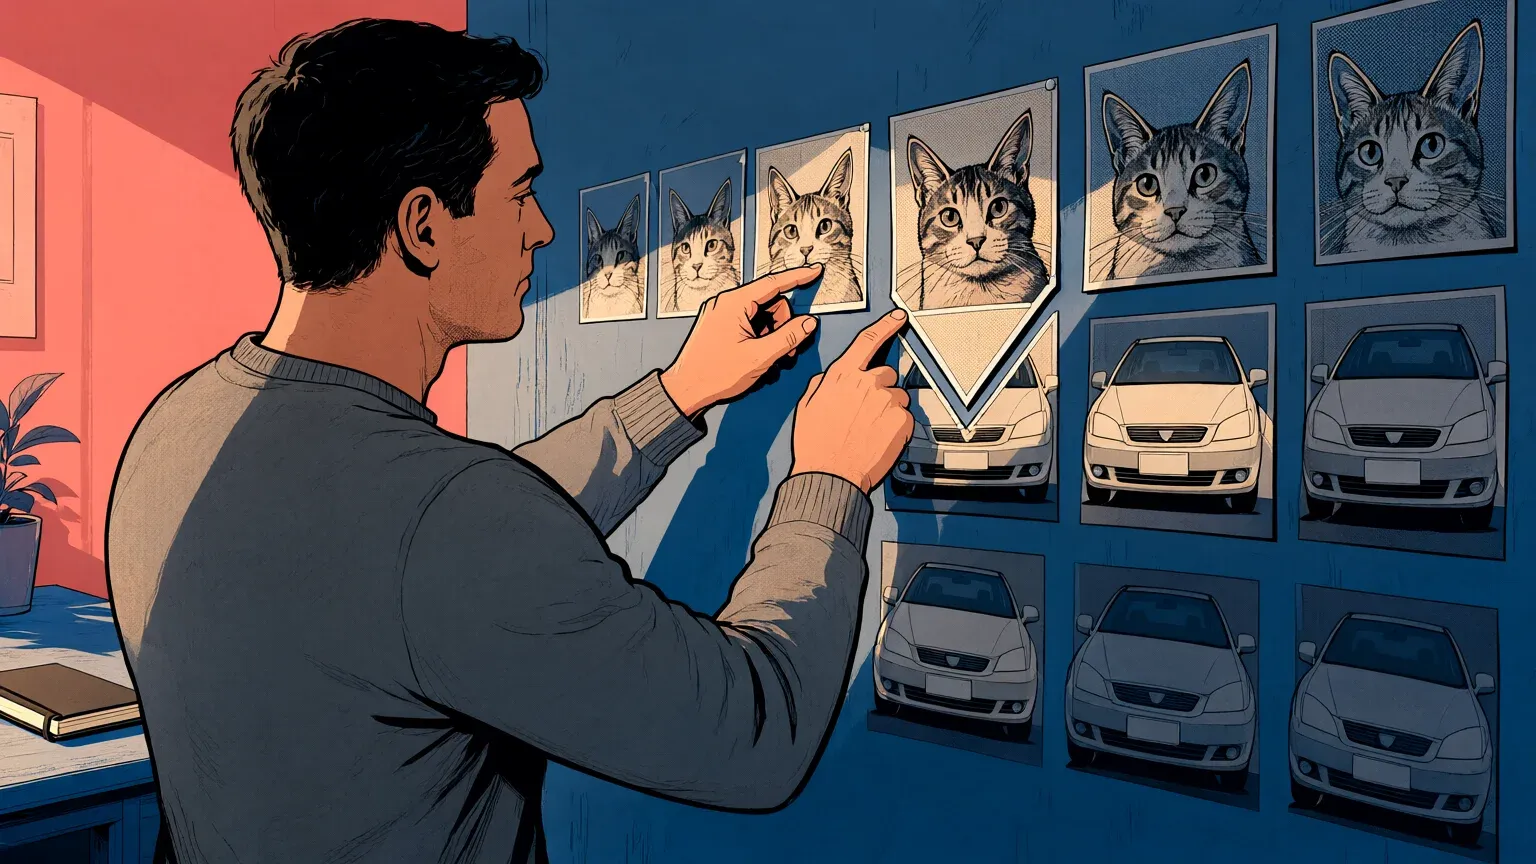
Cammarata usa um exemplo didático: um único neurônio artificial se ativa tanto diante da imagem de um gato quanto da frente de um carro. Em bom português, isso pareceria um erro de fiação — um neurônio "burro" misturando coisas que não têm nada a ver. Só que, segundo a teoria, não é bem assim: pode haver uma característica visual comum entre os dois, como uma forma triangular, que não salta aos olhos humanos, mas que o modelo capturou. Ou seja, o padrão existiria — só precisaríamos aprender a lê-lo.
Promessa: uma IA mais legível
Se a hipótese se confirmar em escala maior, cientistas poderiam identificar com mais precisão por que um modelo de IA toma determinada decisão, inclusive quando o comportamento é indesejado ou perigoso. Isso reforçaria outras estratégias de segurança já usadas hoje, como a análise da "cadeia de pensamento" (chain of thought), o raciocínio passo a passo que alguns modelos exibem antes de responder.
O limite: ainda é só uma teoria
Aqui vai o outro lado da história: nada disso foi demonstrado de forma definitiva. O próprio texto que descreve a proposta é claro ao afirmar que ela não representa uma prova de que todos os mecanismos internos de uma IA já podem ser compreendidos. É um caminho promissor de pesquisa, não um mapa completo. Entender a mente artificial, pelo visto, ainda vai exigir muito trabalho — mas pelo menos agora há uma pista de que o quebra-cabeça pode ter solução.
Atualização (21/10, 00:52): Um ensaio que circula entre pesquisadores de IA sugere que o interior das redes neurais é mais organizado do que se pensava, reabrindo a discussão sobre interpretabilidade. A ideia divide especialistas entre o entusiasmo e a cautela.