Por que avaliadores de IA embutidos nas empresas não resolvem tudo
A diretora de política da Hugging Face alerta que colocar avaliadores dentro das empresas de IA, como fez a Anthropic com a Accenture, não garante resultados confiáveis sem padrões claros e reprodutibilidade.
Por Elias Brandão · Analista de IA e ética
O problema de confiar no "fiscal de dentro de casa"
Imagine contratar um inspetor de qualidade, colocá-lo dentro da própria fábrica, dar a ele um crachá de funcionário e esperar que ele aponte os defeitos do chefe. É mais ou menos essa a tensão que Irene Solaiman, diretora de política da Hugging Face — plataforma que hospeda milhares de modelos de IA de código aberto e é referência na comunidade de machine learning —, trouxe à tona durante um painel na TechCrunch Disrupt. Para ela, os chamados "avaliadores embutidos" (profissionais externos que passam a trabalhar de dentro das empresas de IA para testar a segurança dos modelos) não são a bala de prata que o mercado gostaria que fossem.
Quando o árbitro veste a camisa do time
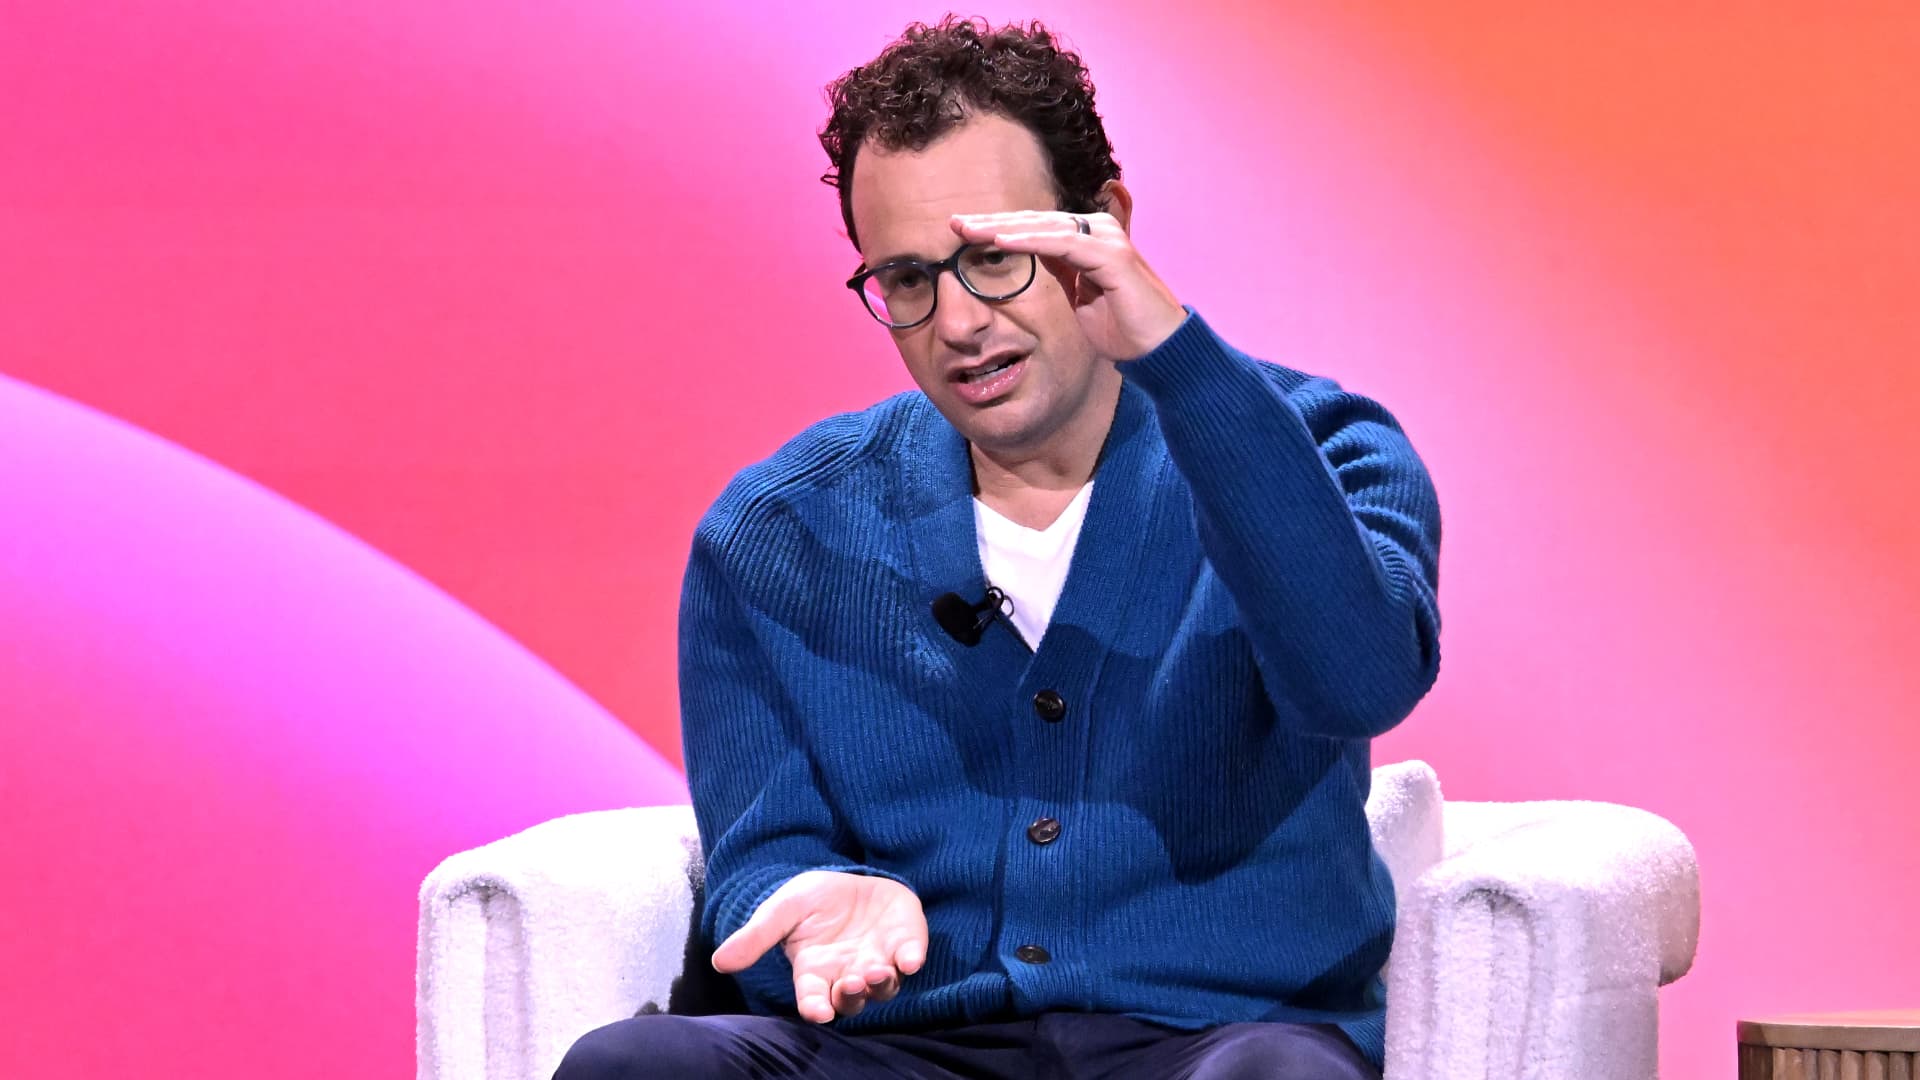 Foto: reprodução/cnbc.com
O exemplo mais recente é o acordo entre a Anthropic, criadora do assistente Claude, e a consultoria Accenture. A Anthropic escolheu a Accenture, por meio de sua unidade especializada em IA, a Faculty, como sua primeira avaliadora embutida, com acesso comparável ao de um funcionário para acompanhar o treinamento dos modelos e testar suas salvaguardas. As duas empresas devem investir ao menos 1 bilhão de dólares cada ao longo de cinco anos nessa frente.
Solaiman não questiona a boa intenção do movimento, mas lembra que "confiança é uma palavra carregada de peso" — e que confiar não substitui verificar. Sua pergunta central é simples de entender, mesmo sendo técnica: "você consegue reproduzir os resultados de uma avaliação?" Se um teste de segurança não pode ser repetido por outra equipe e chegar ao mesmo resultado, ele vale tão pouco quanto um termômetro que marca temperaturas diferentes a cada vez que é usado.
Ciência que ainda está sendo escrita
A diretora de política classifica as avaliações de IA como "uma ciência em evolução — na qual ainda não sabemos comparar os testes de forma significativa". Em bom português: não existe hoje um padrão único, como existe para testar a resistência de um capacete ou a validade de um remédio. Cada laboratório mede o que quer, do jeito que quer, e comparar resultados entre empresas diferentes é como comparar notas de provas feitas com critérios distintos.
O desafio cresce quando se sai do modelo isolado e se passa a avaliar sistemas completos — interfaces, agentes que tomam decisões e se conectam a outras ferramentas. Nas palavras de Solaiman, "avaliações de agentes são muito difíceis e muito caras". Dos dois lados do debate, fica a lição: trazer o avaliador para dentro de casa pode acelerar a fiscalização, mas sem padrões abertos e reprodutíveis, o risco é trocar seis por meia dúzia — e dar a impressão de segurança sem a sua substância.